RAG для бизнеса: как выбрать архитектуру, оценить качество и не переплатить за сложность
Разбираем, что влияет на качество, скорость и стоимость AI-решения. Статья поможет понять, как устроена RAG-система, подходит ли она под ваши задачи и что учесть, чтобы сократить затраты на разработку
В продажах, строительстве, производстве, промышленности и финансах сотрудники ежедневно работают со множеством регламентов, ГОСТов и внутренних документов. Чтобы отвечать клиентам, готовить отчёты, проходить проверки, информацию приходится искать в нескольких системах и сверять с первоисточниками. На это может уходить до двух часов в день.
Сократить время поиска до нескольких минут помогают AI-решения на основе RAG. LLM подключается к корпоративным источникам и отвечает по ним на запросы пользователей.
Качество, скорость отклика и стоимость такого решения зависят не только от выбранной модели. На эти показатели влияют исходные данные, сложность запросов, архитектура RAG-системы, настройки поиска и проверяемость ответов.
В статье разберём, всегда ли внедрение RAG экономически оправдано, как выбрать подходящий пайплайн, оценивать качество ответов и сократить затраты на внедрение и эксплуатацию.
Что такое RAG, какие задачи он решает и всегда ли нужен
RAG (Retrieval-Augmented Generation) — это подход, при котором большая языковая модель отвечает на запрос пользователя по внутренней базе знаний. Сначала система находит релевантные фрагменты документов, ранжирует их и передаёт контекст в LLM. По этим данным модель генерирует ответ и возвращает его пользователю.
Сегодня RAG — основа LLM-агентов, которые работают с корпоративными данными. У этого метода есть преимущества по сравнению с обычной генерацией, когда модель отвечает по исходному датасету. Так компании, которые используют технологию RAG, решают следующие задачи:
- ускоряют работу с базами знаний;
- снижают нагрузку на экспертов компании;
- уменьшают человеческий фактор;
- упрощают обновление и масштабирование.
Однако не всегда решения на основе RAG экономически оправданы. Например, когда у пользователей много простых вопросов, на которые можно отвечать шаблонами ответов, как в FAQ, внедрение RAG увеличивает стоимость и время обработки запроса без улучшения качества. Для таких задач больше подходит классификатор интентов. Он определяет, к какой теме относится запрос, даже если он сформулирован по-разному, и по ID находит подходящий вариант ответа.
Часто эффективнее применять гибридный подход: для типовых вопросов использовать шаблоны, а для нестандартных — поиск по базе знаний.
Типы RAG-пайплайнов и как выбрать подходящий
Глобально RAG делят на классический и агентский. Оба пайплайна работают с каталогом данных, но по-разному управляют поиском и контекстом для генерации ответа.
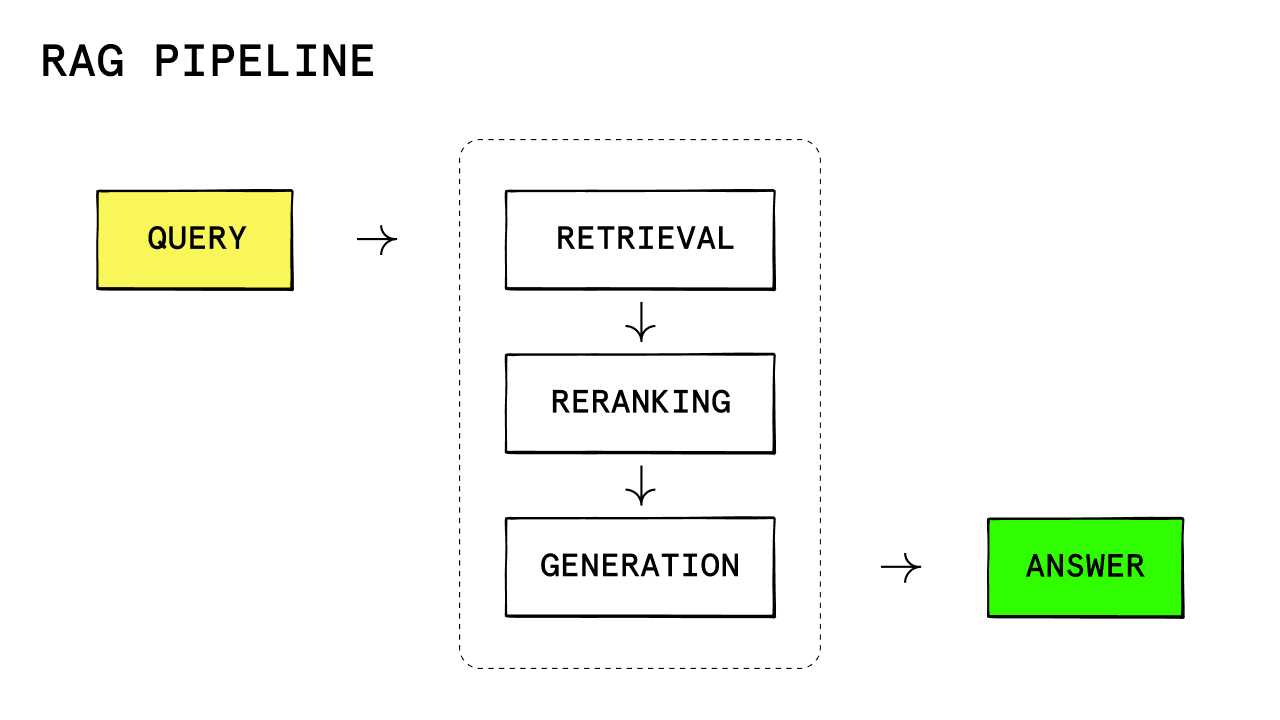
Классический RAG — линейный однопроходный процесс: запрос → поиск → ответ. Такой метод лучше работает для простых вопросов, когда вся необходимая информация содержится в одном-двух фрагментах документов. Он легче и дешевле в разработке, тестировании и эксплуатации.
В агентском RAG поиском управляет LLM: выбирает источник и инструмент, определяет количество итераций и при необходимости корректирует запрос и контекст.
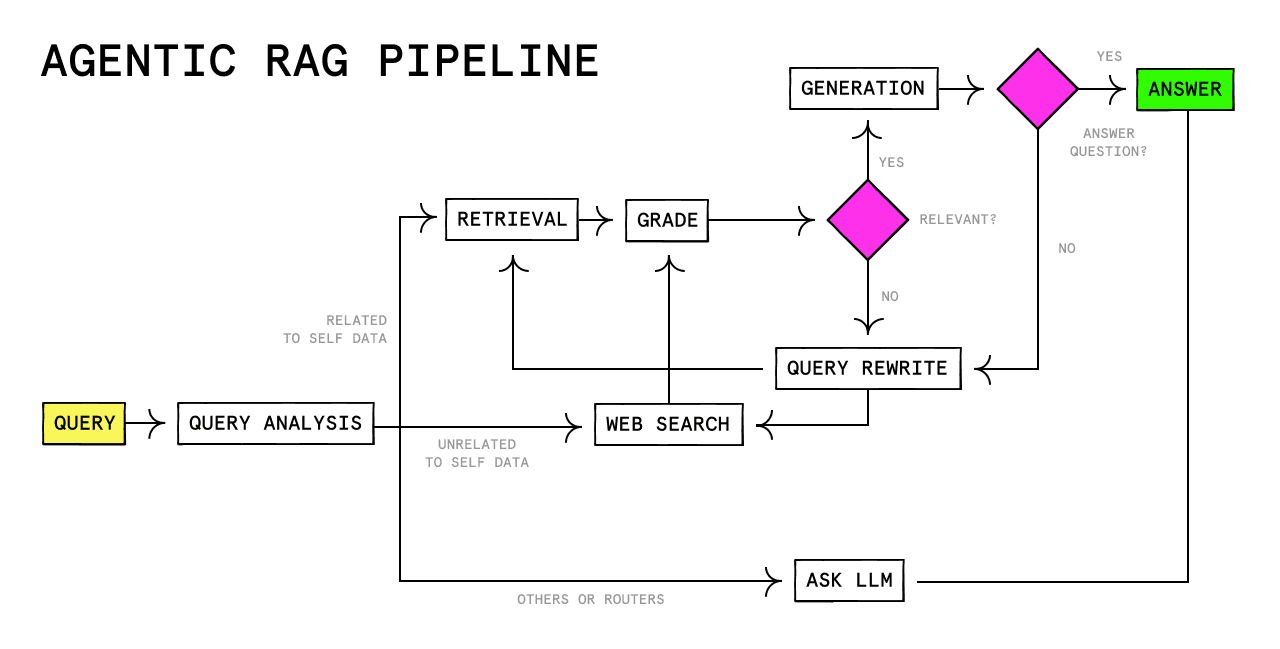
Агентский RAG более гибкий и адаптивный. Может отвечать как на простые, так и на сложные аналитические запросы, для которых нужно объединить несколько фактов из разрозненных источников.
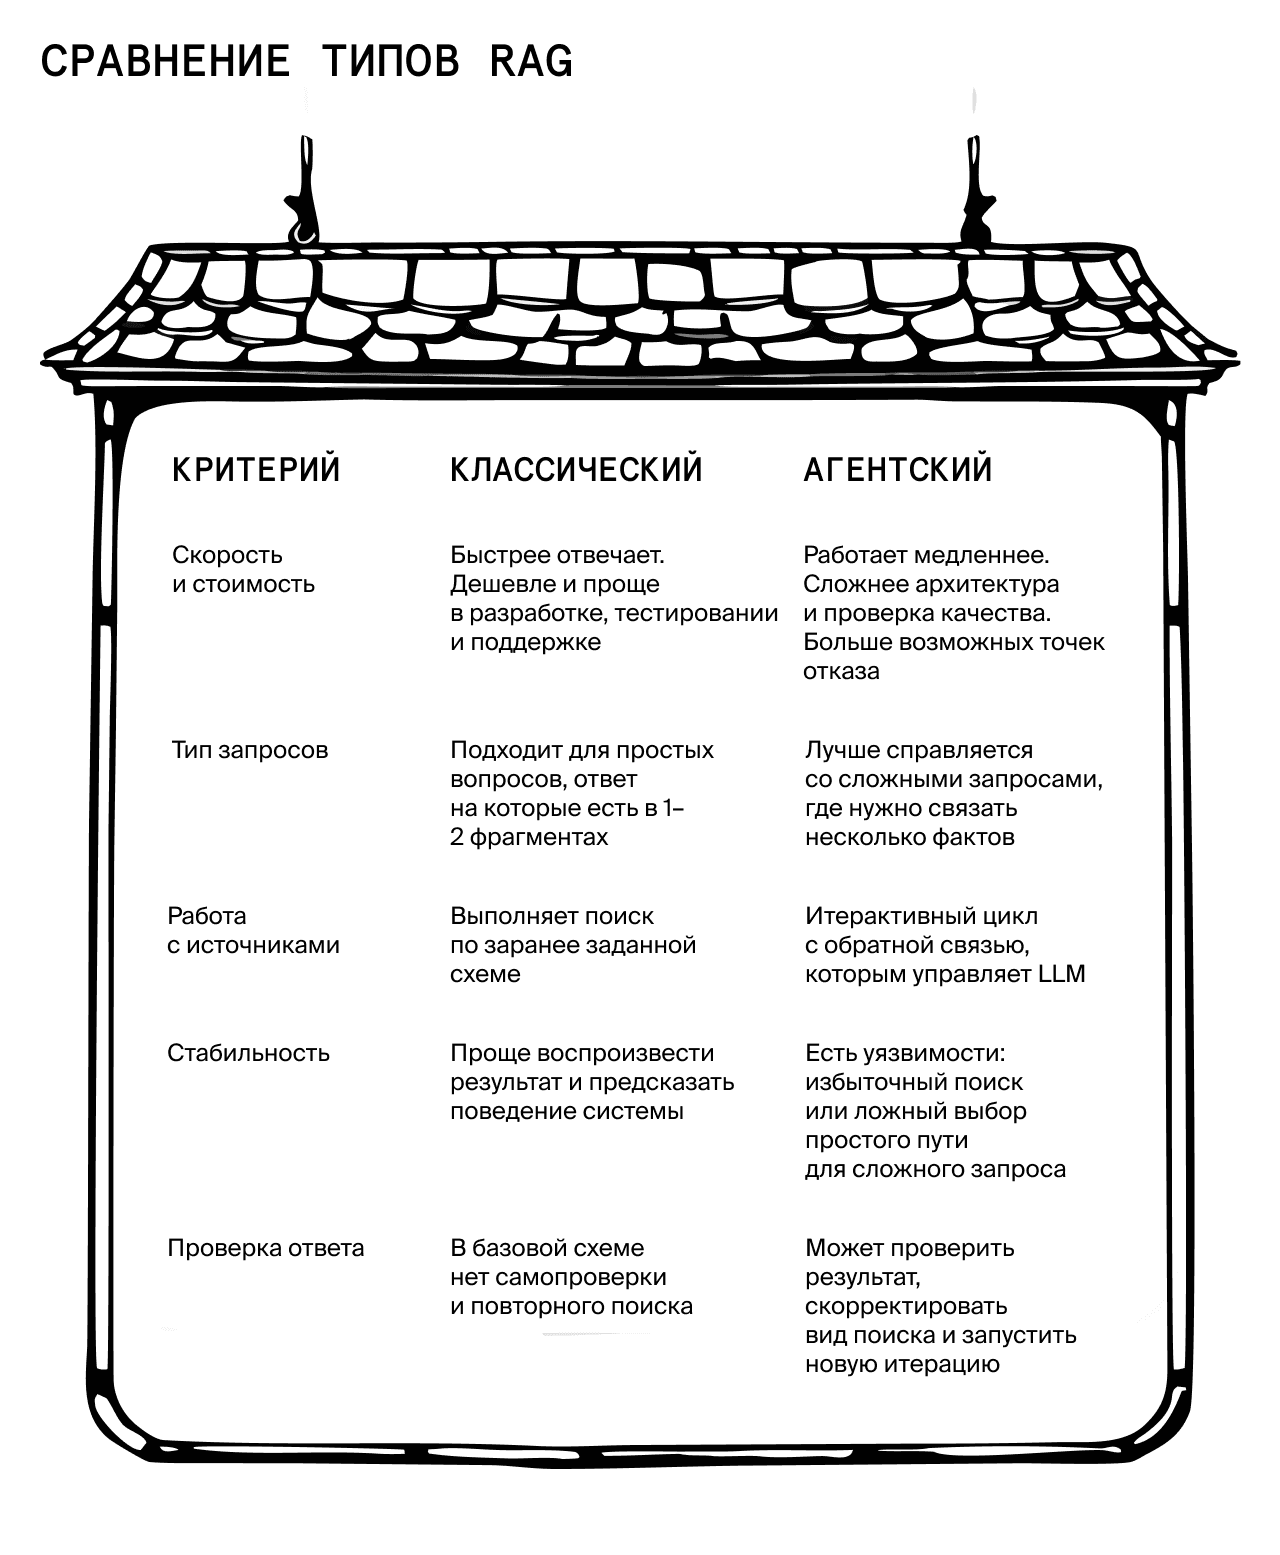
Начинать внедрение стоит с классического RAG, потому что это решение быстрее и дешевле. Если практика показывает, что уровень качества ответов недостаточный, можно добавить агентский вариант и распределять запросы.
«Обычно используют такую SOTA-стратегию: в систему добавляют маршрутизатор, который направляет простые вопросы в классический RAG, а сложные — в агентский. Чаще всего это соотношение 80 и 20% соответственно. Это позволяет не запускать более дорогой агентский цикл без необходимости».
Екатерина Пославская, ML-разработчик KTS
Чтобы понять, как работает RAG, разберём три ключевых блока любого пайплайна: индексацию, поиск и генерацию. Дальше подробно объясняем, что происходит в системе на каждом этапе.
Как устроена индексация документов в RAG
Сначала система извлекает из документов текст, таблицы и другие данные. Затем делит эти материалы на чанки — фрагменты, по которым будет искать информацию.
Есть несколько способов чанкинга. Самый простой — делить текст на фрагменты одинаковой длины. Если у документа есть естественная структура, дополнительно учитывают смысловые и структурные секции. Для сложных материалов, где смешаны текст, таблицы и изображения, можно использовать LLM. Но такая обработка увеличивает стоимость и продолжительность индексации.
Размер фрагмента зависит от содержания документов и запросов пользователей. Это всегда компромисс между точностью и полнотой контекста. Для коротких вопросов, например, о расположении банкоматов или обновлении приложения, может быть достаточно 200 токенов. В рабочих системах обычно используют чанки размером 512–1024 токена. Для насыщенных информацией материалов, например, юридических документов, — 1024–2048 токенов.
Соседние чанки обычно берут с пересечением 10% от их длины. Это помогает сохранить смысл на границе фрагментов.
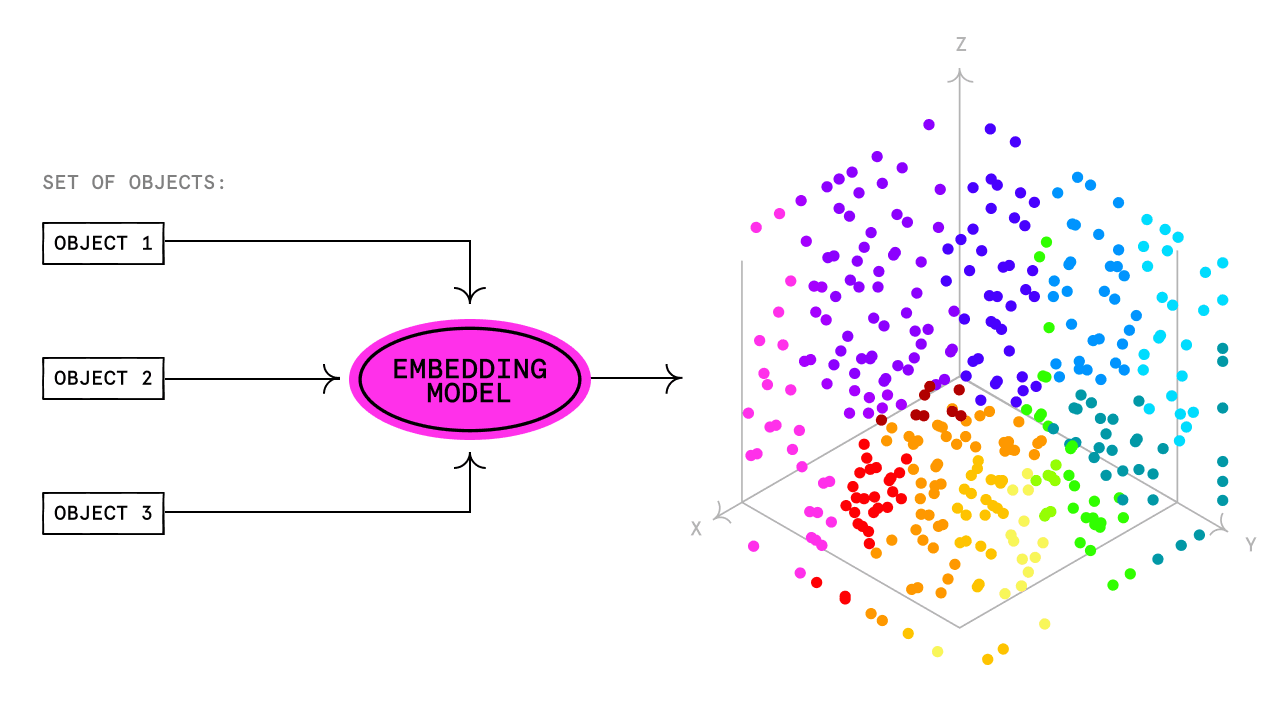
Далее система с помощью embedding-модели преобразует чанки в векторы и сохраняет их в хранилище. Так формируется векторный индекс: упорядоченный каталог корпоративных данных.
Как работает поиск в RAG и какой подход выбрать
Когда пользователь задаёт вопрос, система обрабатывает его и обращается к индексу. Она находит релевантные фрагменты, ранжирует их и формирует топ-N — это контекст для языковой модели.
Алгоритм поиска определяется структурой индекса и задачей:
- семантический поиск на основе векторов находит фрагменты, близкие к запросу по смыслу;
- полнотекстовый (BM25) ищет точные совпадения слов;
- гибридный поиск объединяет два предыдущих подхода;
- графовый учитывает сущности и связи между ними;
- мультимодальный поиск позволяет искать по текстам, таблицам, формулам и изображениям.
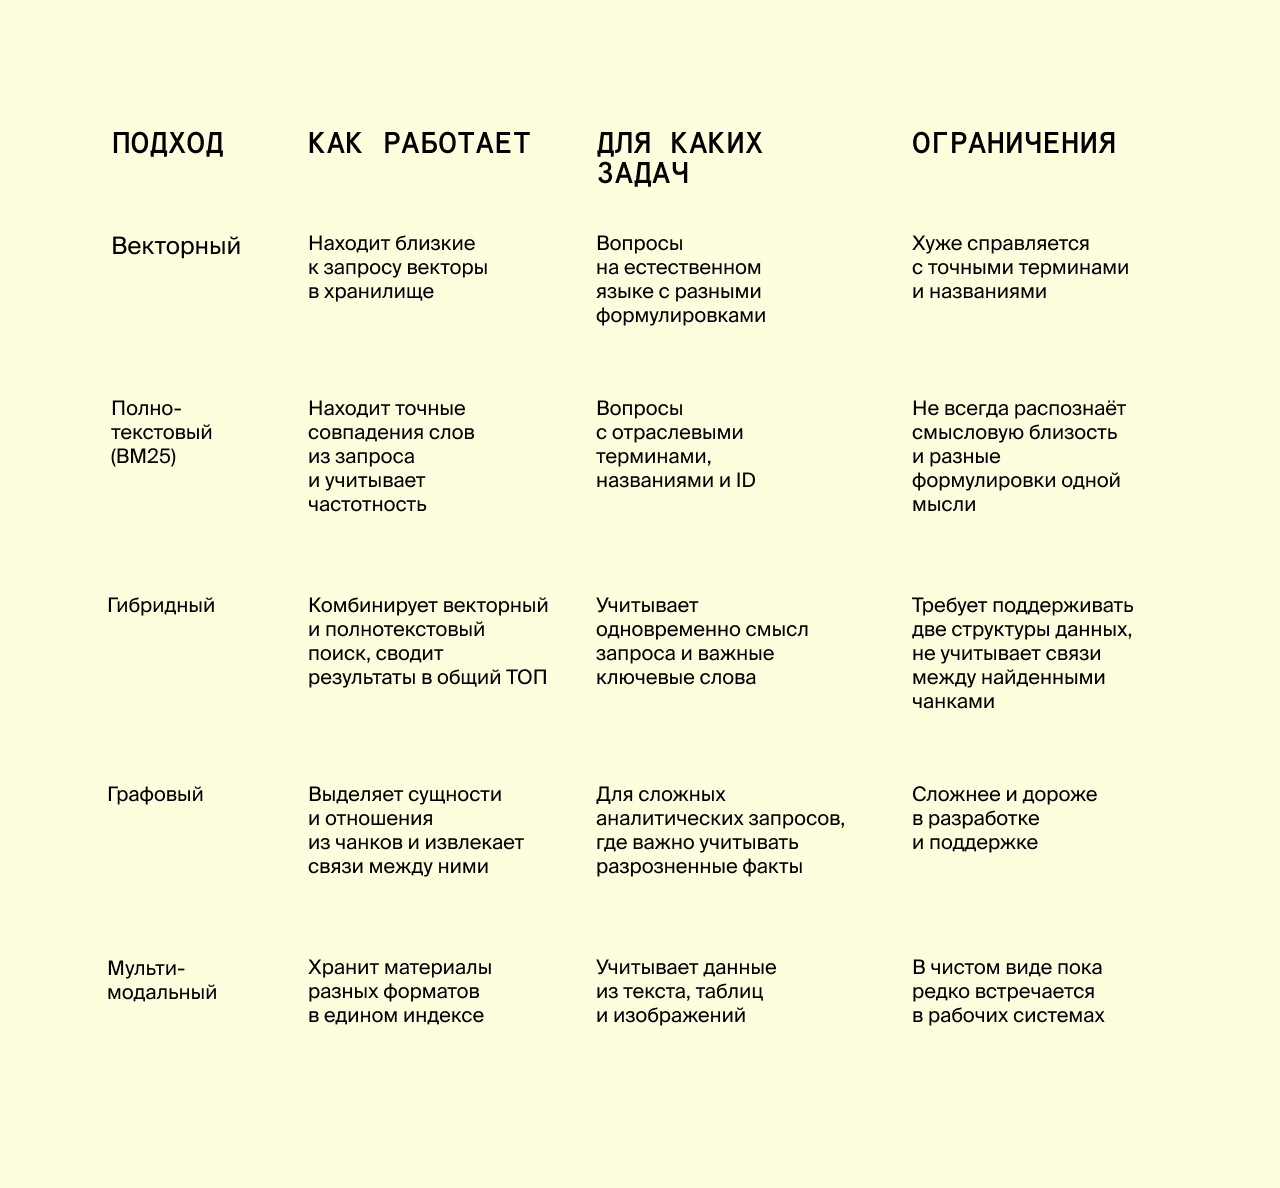
Лучше начинать с гибридного индекса — это оптимальный вариант по точности и стоимости. Графовый поиск стоит подключать, когда уровень качества ответов неудовлетворительный и тесты показали, что причина не в исходных данных.
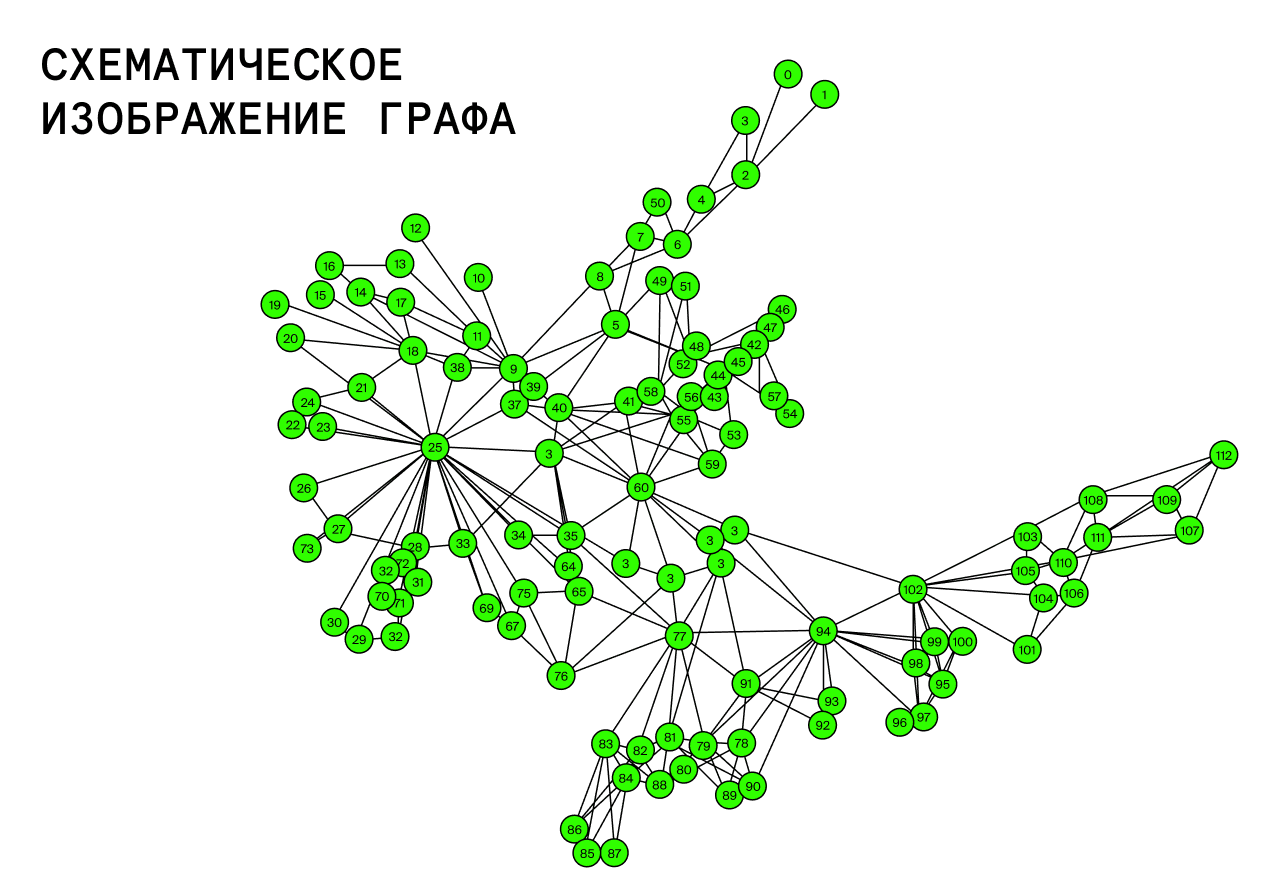
«Графовый поиск может быть альтернативой агентскому RAG для сложных аналитических запросов. Например, когда в одной статье указаны условия кредита, а в другой — есть информация о льготах. Он найдёт эту связь и объединит информацию.
Но создавать графовые базы сложнее и дольше. Появилась новая статья, и нам нужно перестроить весь граф. Это влияет на стоимость разработки и поддержки. Частые обновления обходятся дорого».
Екатерина Пославская, ML-разработчик KTS
Генерация: как управлять ответом LLM
После поиска система передаёт языковой модели вопрос пользователя и набор релевантных фрагментов. На качество обработки этого контекста и генерации влияет системный промпт — инструкция, которая определяет поведение ИИ-агента.
Единого шаблона промпта для модели нет. Можно начать с базовой структуры и, если нужно, доработать её под ваши цели:
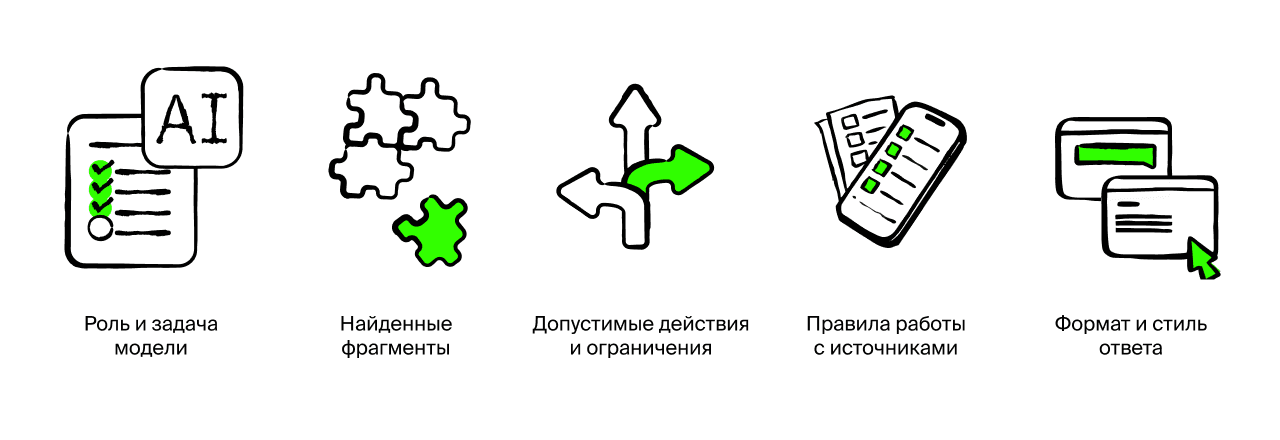
Например, в системном промпте можно запретить модели использовать информацию вне контекста, попросить сообщать о нехватке данных и добавлять ссылку на источник после каждого утверждения.
На результат также влияют параметры генерации:
- Temperature: определяет вариативность ответа. Для фактологических задач обычно устанавливают значение от 0 до 0,3, чтобы результаты были более предсказуемыми.
- Max tokens: ограничивает максимальное количество токенов, которое можно потратить. Это помогает контролировать расходы на генерацию.
- Citation enforcement: требует, чтобы модель подтверждала информацию ссылками на источники и приводила цитаты при необходимости.
Дополнительно можно проверять ответы с помощью LLM, которая выступает в роли судьи. Она оценивает черновик, созданный основной моделью, по параметру faithfulness — соответствие найденному контексту. Это помогает обнаружить утверждения, которых не было в переданных фрагментах, и снизить риск галлюцинаций.
Как оценивать качество RAG-системы: практический подход
В академической среде работу RAG оценивают по множеству показателей: релевантности ответа, частоте галлюцинаций, времени и стоимости обработки запроса, количеству итераций в агентском пайплайне и другим. Однако для расчёта этих метрик нужен размеченный датасет с эталонными ответами. Это требует значительных затрат со стороны экспертов заказчика.
На практике оценку качества RAG упрощают и ускоряют. Для этого используют связку LLM-as-a-judge + экспертная проверка и проходят несколько этапов.
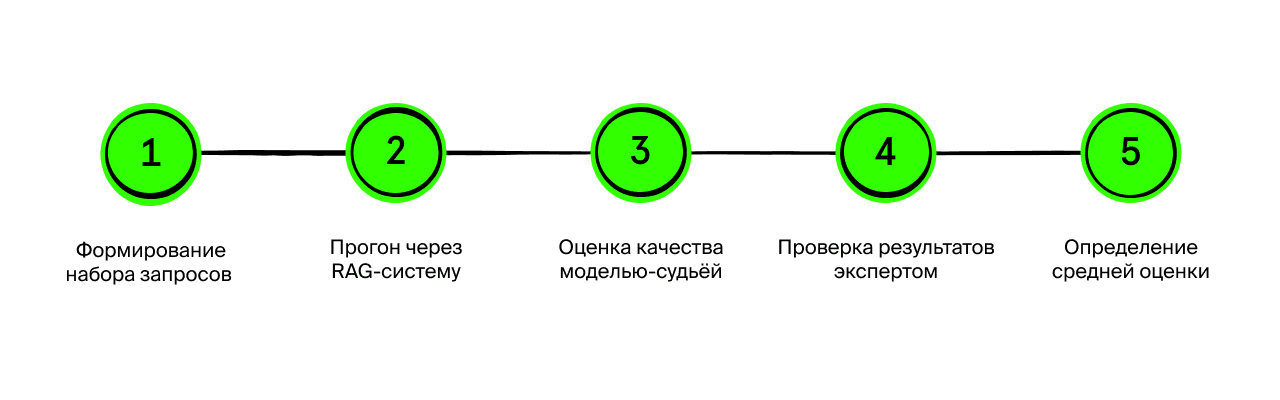
1. Собирают репрезентативный набор запросов. Обычно достаточно 50–200 типовых вопросов и ответов. Например, реальные обращения из службы поддержки или HR.
2. Прогоняют набор через RAG-систему. Сохраняют найденные чанки, ссылки на источники и ответы модели. Эти данные понадобятся для проверки.
3. Оценивают качество ответов. LLM-судья проверяет результаты по заранее заданным критериям. Например, таким:
- correctness — правильно ли система ответила по существу;
- completeness — полностью ли раскрыла вопрос;
- groundedness — насколько опирается на предоставленный контекст без фантазий;
- conciseness — много ли воды в ответе;
- citation quality — если требуется цитирование.
Обычно для оценки используют бинарную шкалу «хорошо — плохо». Но наш опыт показывает, что лучше выставлять баллы от 1 до 10. Это позволяет анализировать качество ответов по разным критериям и помогает понять, где есть узкие места.
4. Эксперт проверяет результаты. На этапе предпродакшена специалист заказчика оценивает всю выборку и правит ответы. Это занимает намного меньше времени, чем составление эталонного набора данных с нуля.
5. Определяют среднюю оценку. Ответы языковой модели могут различаться даже при одинаковом запросе, поэтому одного прогона недостаточно. Чем меньше тестовая выборка, тем больше нужно повторов. Например, набор из 50 вопросов лучше прогнать не менее пяти раз, рассчитать среднюю оценку и оценить динамику.
В продакшене продолжают следить за уровнем качества работы RAG-системы. Эксперт вручную проверяет 10–20% выборки. Например, разбирает сложные кейсы или случаи, когда LLM-судья поставила от 4 до 6 баллов. Специалист определяет причины низких оценок, и команда разработки устраняет недостатки.
«Иногда компании используют пользовательское голосование. Но я не рекомендую таким способом оценивать качество ответов. У нас нет контекста, мы не знаем, почему пользователь нажал единицу или дизлайк. Может, случайно или у него настроение плохое. Поэтому лучше использовать для оценки качества только экспертную валидацию».
Екатерина Пославская, ML-разработчик KTS
5 реальных проблем RAG-систем и как их исправить
Собрали основные сложности, с которыми компании сталкиваются после запуска:
1. Качество системы деградирует со временем. Основные причины — снижение актуальности данных, появление дублей, противоречий и двойственных условий по мере роста базы знаний. Чем больше такого шума, тем сложнее подобрать релевантные чанки.
Чтобы поддерживать качество поиска, нужна гигиена данных. Раньше такая работа требовала значительных ресурсов со стороны заказчика. Сейчас часть процесса можно автоматизировать с помощью ИИ. Например, мы в KTS используем Data Validator: он находит дубли и возможные противоречия в RAG-базе знаний. Эксперт оценивает результаты проверки и решает, какие данные нужно исправить, объединить или удалить.
Другие причины деградации качества — изменение парсера, размера фрагментов, embedding-модели, аудитории или актуальных для неё тем. Поэтому проводят гигиену индекса и используют версионирование компонентов. Также после обновления систему прогоняют на эталонном датасете и проверяют, не ухудшились ли результаты.
2. Низкое качество ответов. Сначала проверяют, попал ли нужный факт в найденные чанки. Если нет, проблема в поиске. Чтобы её исправить, расширяют и структурируют запрос, меняют параметры ранжирования и делят базу на тематические разделы.
Если дело не в поиске, дорабатывают генерацию: промпт, температуру, правила цитирования и самопроверку.
3. Медленные и дорогие ответы. Снизить затраты помогают кеширование одинаковых и похожих обращений, маршрутизация запросов и оптимизация контекста. Например, можно уменьшить количество чанков в топ-N или разбить слишком крупные фрагменты, чтобы LLM не получала лишние данные.
4. Галлюцинации и вымышленные цитаты. Сегодня LLM стали значительно умнее, поэтому чаще проблема в исходных данных. Например, модель отвечает по реальному документу, но в нём есть опечатка или неактуальная информация.
Если проблема не в данных, используют строгий промпт, добавляют требование предоставить ссылки на источники и постпроверку ответа. В критичных сценариях результаты дополнительно оценивает эксперт.
5. В ответах смешиваются данные из разных предметных областей. Например, отвечая на вопрос про HR, система использует документы финансового отдела. Чтобы этого избежать, базу делят на домены и создают для каждой свой индекс. Также помогает фильтрация документов по метаданным. В результате уменьшается контекст, повышается скорость и точность ответа.
Как сократить затраты на разработку и масштабирование RAG
Для вывода AI-решения в продакшен нужно собрать архитектуру, подключить корпоративные источники, обеспечить безопасность данных и настроить контроль качества, скорости и стоимости. Когда этот цикл повторяют для каждого нового агента, масштабирование получается сложным и дорогим. Поэтому часто проекты остаются на уровне пилота, и затраты не окупаются.
Чтобы ускорить разработку RAG-систем, мы в KTS используем AI Platform — это единый стек из трёх платформ для работы с агентами, данными и LLM. Готовые компоненты позволяют быстрее переходить от прототипа к продакшену и запускать новых агентов на общей инфраструктуре.
Решение можно развернуть в закрытом контуре заказчика или российских облаках. Единый LLM-шлюз обеспечивает доступ к разным моделям, а ПДн-роутер распределяет запросы на основании содержимого и политики безопасности. Функциональность платформы позволяет отслеживать токены, стоимость и латентность по каждому запросу.
Благодаря AI Platform компании быстрее переходят к промышленной эксплуатации, контролируют бюджет и сокращают затраты на масштабирование.
Начните с демо на ваших данных. Напишите нам, дадим доступ к настроенной базе знаний: загрузите примеры своих документов и оцените, как по ним отвечает AI-ассистент.