У провайдера хорошо, но свой инференс дешевле (на 80%)
Клиент: Фотобудка, сервис персонализированной генерации фото
Ниша: генеративный AI, B2C
Услуга: инфраструктура для инференса моделей, бэкенд-разработка, DevOps
Контекст
Фотобудка — сервис, который генерирует персонализированные фотографии. Человек загружает несколько своих снимков и получает изображения с собой в любом антураже.
Черты конкретного человека модель получает из LoRA (компактной надстройки над основной моделью, которую дообучают на его снимках). Потом LoRA подключают к базовой генеративной модели, и сервис генерирует изображения уже с этим человеком.
И дообучение, и генерацию заказчик делал у облачного провайдера инференса. В такой сервис загружают модель и данные, а платят за каждый запуск. На старте это удобно, потому что не нужно покупать серверы и разбираться с драйверами видеокарт.
Дальше счёт начал расти вместе с аудиторией. Каждый пользователь приносил новые запуски модели, и генерация стала одной из главных статей расходов. Цена запуска была фиксированной и не зависела от того, сколько сервис генерирует, а повлиять на неё заказчик не мог. Поэтому команда и пришла в KTS с вопросом, будет ли дешевле генерировать на своих видеокартах.
Задача
- Не переписывать продукт. Заказчик уже интегрирован с API провайдера, так что наш API должен быть совместимым.
- Сохранить надёжность. Пользователь Фотобудки ждёт картинку здесь и сейчас и должен получить её, даже если что-то сломалось.
- Снизить стоимость генерации. Свои GPU оплачиваются по фиксу, поэтому железо не должно простаивать. Нужно найти баланс.
Подход: гибридная схема
Видеокарты оплачиваются по фиксу, и не важно, загружены они или простаивают.
- Купить серверов под пик = платить за простои.
- Купить мало = обеспечить пользователям задержки при пиковых нагрузках.
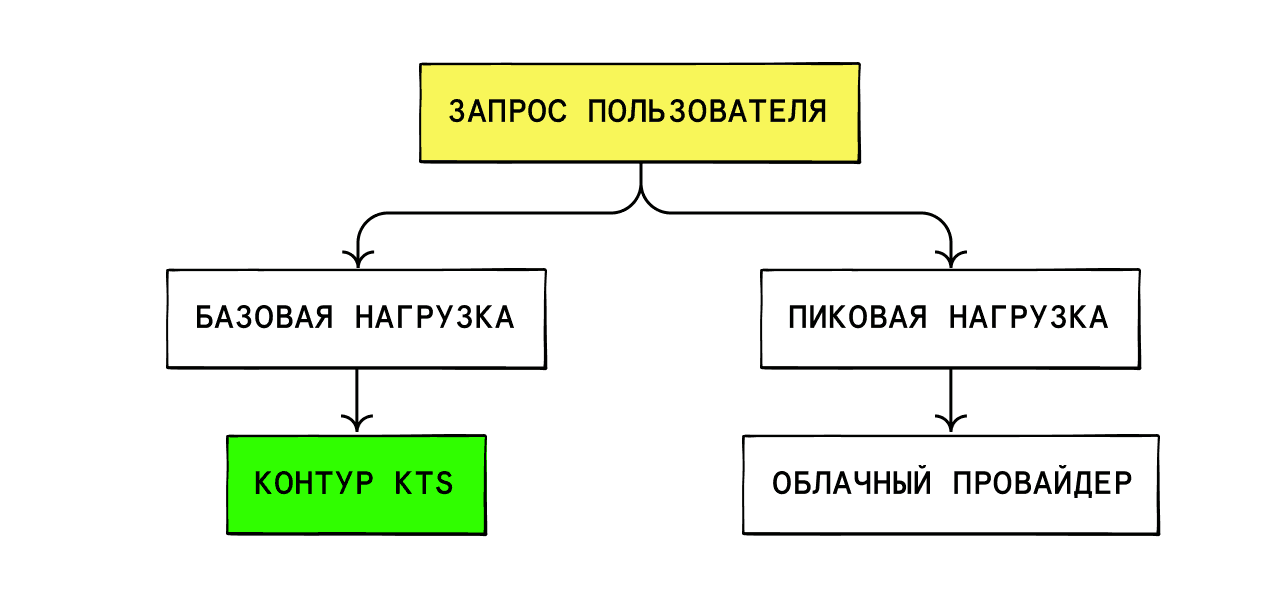
Поэтому мы выбрали гибрид. Постоянный пул выделенных GPU-серверов закрывает базовую нагрузку, а всё, что в него не помещается, уходит прежнему провайдеру по старой интеграции.
Что сделали
Отдел спецпроектов KTS спроектировал API, очередь и обработчик задач, DevOps-юнит развернул кластер, GPU-серверы и мониторинг. Команда заказчика собирала сценарии генерации и проектировала переключение между контурами на своей стороне.
Инфраструктура
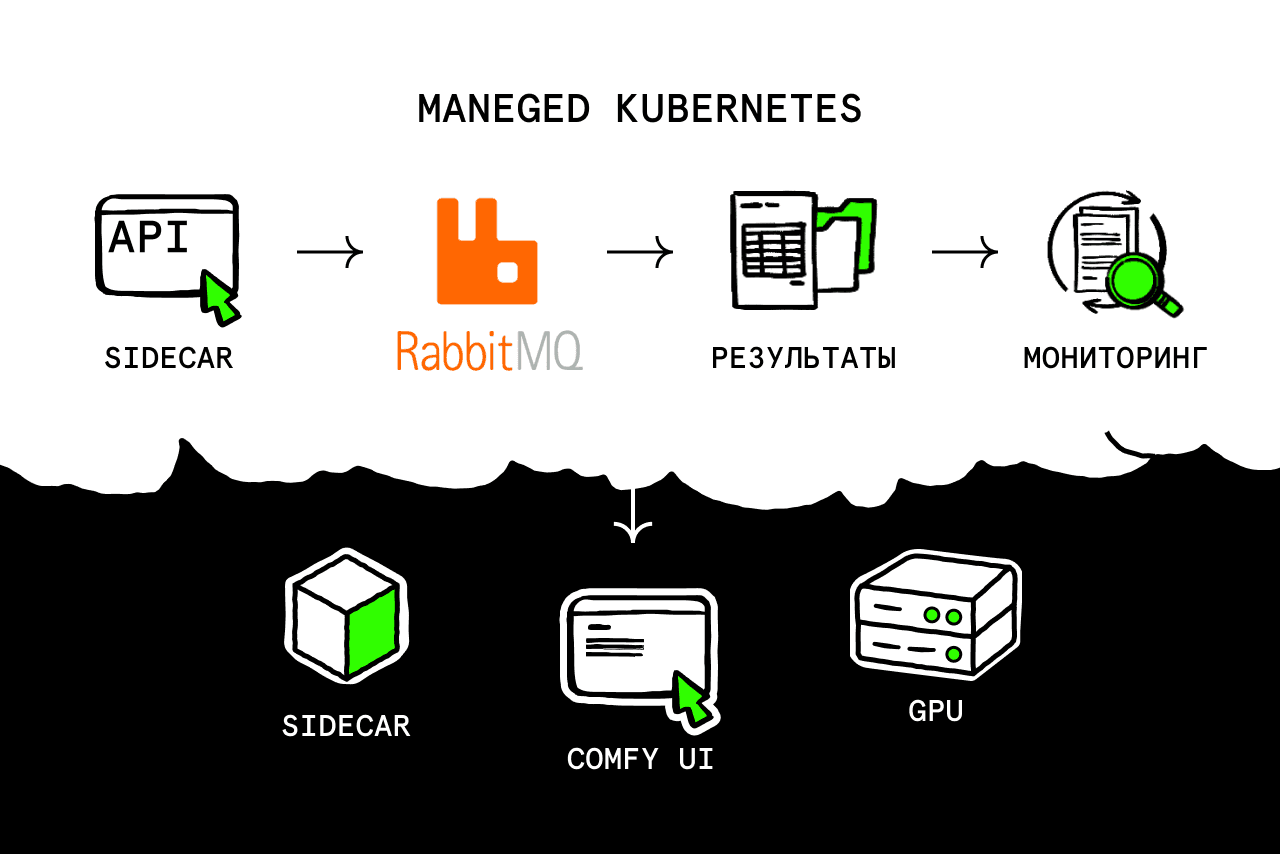
- В managed Kubernetes живёт лёгкая управляющая часть с API, очередью задач на RabbitMQ, доставкой результатов и мониторингом. GPU-серверы вынесены за пределы кластера.
- На каждом GPU-сервере стоят Docker, ComfyUI (движок, который выполняет пайплайны генерации на видеокарте) и наш sidecar-сервис, который забирает задачи из очереди и передаёт их ComfyUI. Kubernetes на GPU-нодах только добавил бы возни с драйверами для разных видеокарт.
Очередь знает лимит своих возможностей
Мы повторили интерфейс API провайдера один в один, включая доставку результата вебхуком (обратным вызовом в систему заказчика). Заказчику осталось добавить только переключение. Запрос сначала идёт в контур KTS, а при ошибке или долгом ответе уходит провайдеру.
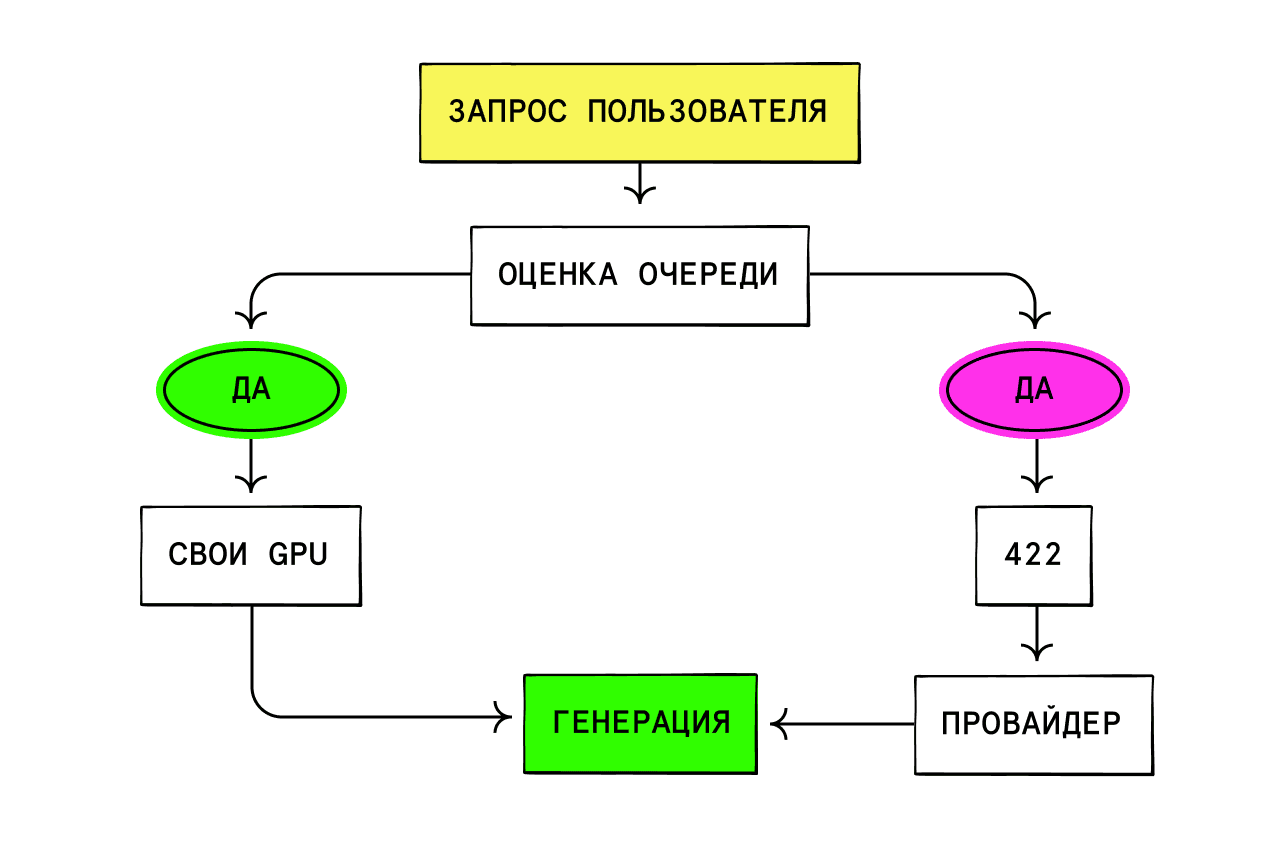
Сервис знает свою пропускную способность и оценивает время ожидания для каждой задачи. Если оно выходит за порог, API сразу отвечает кодом 422 (запрос корректный, но принять его сейчас нельзя), и продукт уходит с ним к провайдеру. Человек не зависает в очереди, а машины KTS остаются загруженными. Так же обрабатывается сбой на машине. Картинку пользователь получает в любом случае, а команда видит проблему в мониторинге.
Видеокарта занята только инференсом
Подготовка задачи (скачать LoRA, собрать пайплайн) и постобработка (сконвертировать изображение, загрузить в хранилище, отправить результат) выполняются в фоне, пока видеокарта считает следующую задачу. Базовые модели загружаются при старте машины и остаются в видеопамяти.
LoRA у каждого пользователя своя, и весит она немало. Поэтому на каждой машине работает кэш на RAM-диске. Sidecar скачивает LoRA заранее, а давно не нужные файлы вычищает сам.
Пайплайны, обновления и дополнительные машины
Сценарий (он же — пайплайн) генерации описывается в ComfyUI в виде графа и экспортируется в JSON. Команда заказчика отмечает в нём метками-заглушками поля, которые приходят из API-запроса (промпт, размер, ссылка на LoRA), и кладёт файл в репозиторий. Имя файла становится путём API, а бэкенд подставляет значения и проверяет типы. Так заказчик добавляет новые сценарии без разработчиков KTS.
ComfyUI обновляется часто, и новые пайплайны нередко требуют свежей версии. Чтобы не останавливать сервис, машины обновляют по одной, а остальные в это время работают.
Добавить машину тоже просто. Роль Ansible (инструмент, который настраивает серверы по описанию) ставит на чистый сервер драйверы NVIDIA, Docker с поддержкой видеокарт и агенты метрик, а три задачи в GitLab разворачивают ComfyUI, синхронизируют модели и ставят sidecar. Машина появляется в Grafana, где по загрузке GPU, времени генерации и длине очереди заказчик сам видит, когда пора добавлять следующую.
Самым сложным оказалось передать проект
Бюджет заказчика был ограничен, а продукт ещё менял форму, поэтому от админки и автоматической покупки машин мы отказались. Часть операций осталась ручной, а в команде заказчика не было инженера с опытом эксплуатации. Мы написали инструкции на каждый сценарий, записали видео и провели несколько вебинаров, где прошли всё руками вместе с командой. В итоге заказчик развернул решение самостоятельно.
Результаты
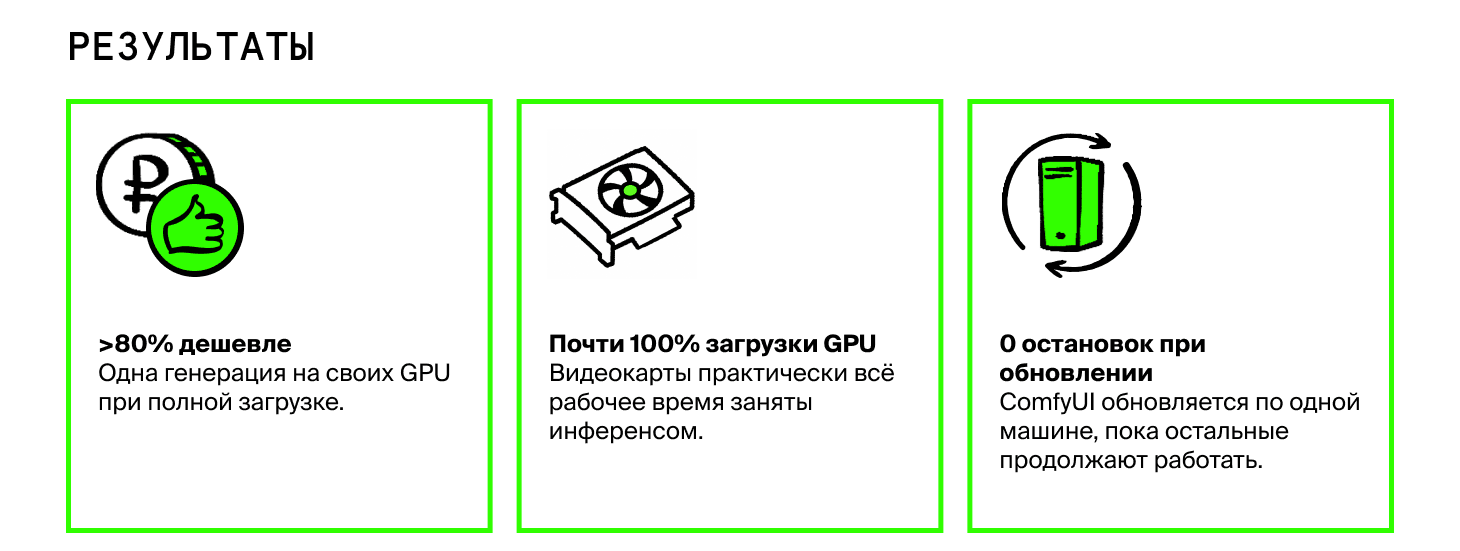
Провайдер берёт фиксированную цену за каждую генерацию. В контуре KTS при полной загрузке одна генерация обходится на 80% дешевле, то есть примерно в шесть раз, в зависимости от видеокарты. При простое серверы стоят столько же, а вечно платить за пик дорого, поэтому провайдер и остался в схеме как буфер.
На реальном трафике схема подтвердила свою состоятельность. Часть генераций шла на выделенные серверы, остальное к провайдеру, и пользователи получали результат в штатном режиме. Стоимость одной генерации зависит от числа арендованных машин, и это число заказчик выбирает сам.