0 даунтаймов
Поэтапная миграция без остановки сервисов
Клиент: ТехноСкор
Ниша: кибербезопасность для финтеха, антифрод, риск-скоринг
Услуга: DevOps, проектирование инфраструктуры, миграция в Yandex Cloud
Срок: около полутора лет, с начала 2024 года до лета 2025 года
0 даунтаймов
Поэтапная миграция без остановки сервисов
−40% простоев
Мультизональная архитектура повысила отказоустойчивость.
Rust-ready инфраструктура
Сеть, мониторинг, логирование и переключение трафика.
ТехноСкор разрабатывает решения для финансовой безопасности. Его антифрод-платформа оценивает риск мошеннической операции и быстро возвращает ответ клиенту. Дальше банк, страховая компания или другой участник финансового рынка уже сам решает, что делать с платежом: провести его, запросить дополнительные данные или отправить операцию на проверку.
Инфраструктура такого продукта должна работать стабильно. Если сервис недоступен, клиент в этот момент не получает оценку риска. Если ответ задерживается на десятки миллисекунд, это может повлиять на работу платёжного сценария, и все такие случаи должны быть видны в метриках.
DevOps-юнит KTS давно помогает ТехноСкору с инфраструктурой. В этом кейсе разбираем один большой этап этой работы: как мы пересобрали инфраструктуру, перевезли ее в Yandex Cloud и подготовили площадку для новой версии продукта на Rust.
Старая площадка решала продуктовые задачи, но становилась неудобной для дальнейшего роста.
Основной контур работал в Kubernetes 1.15. Версия была устаревшей, но обновлять её не хотелось: команда уже понимала, что будет миграция, и лишние изменения в старом проде могли добавить рисков.
Рядом с Kubernetes работал набор виртуальных машин. На них были развёрнуты MongoDB-кластеры под отдельных клиентов. С MongoDB снимались hidden-реплики, то есть скрытые копии, на которых строили аналитику и обучали модели.
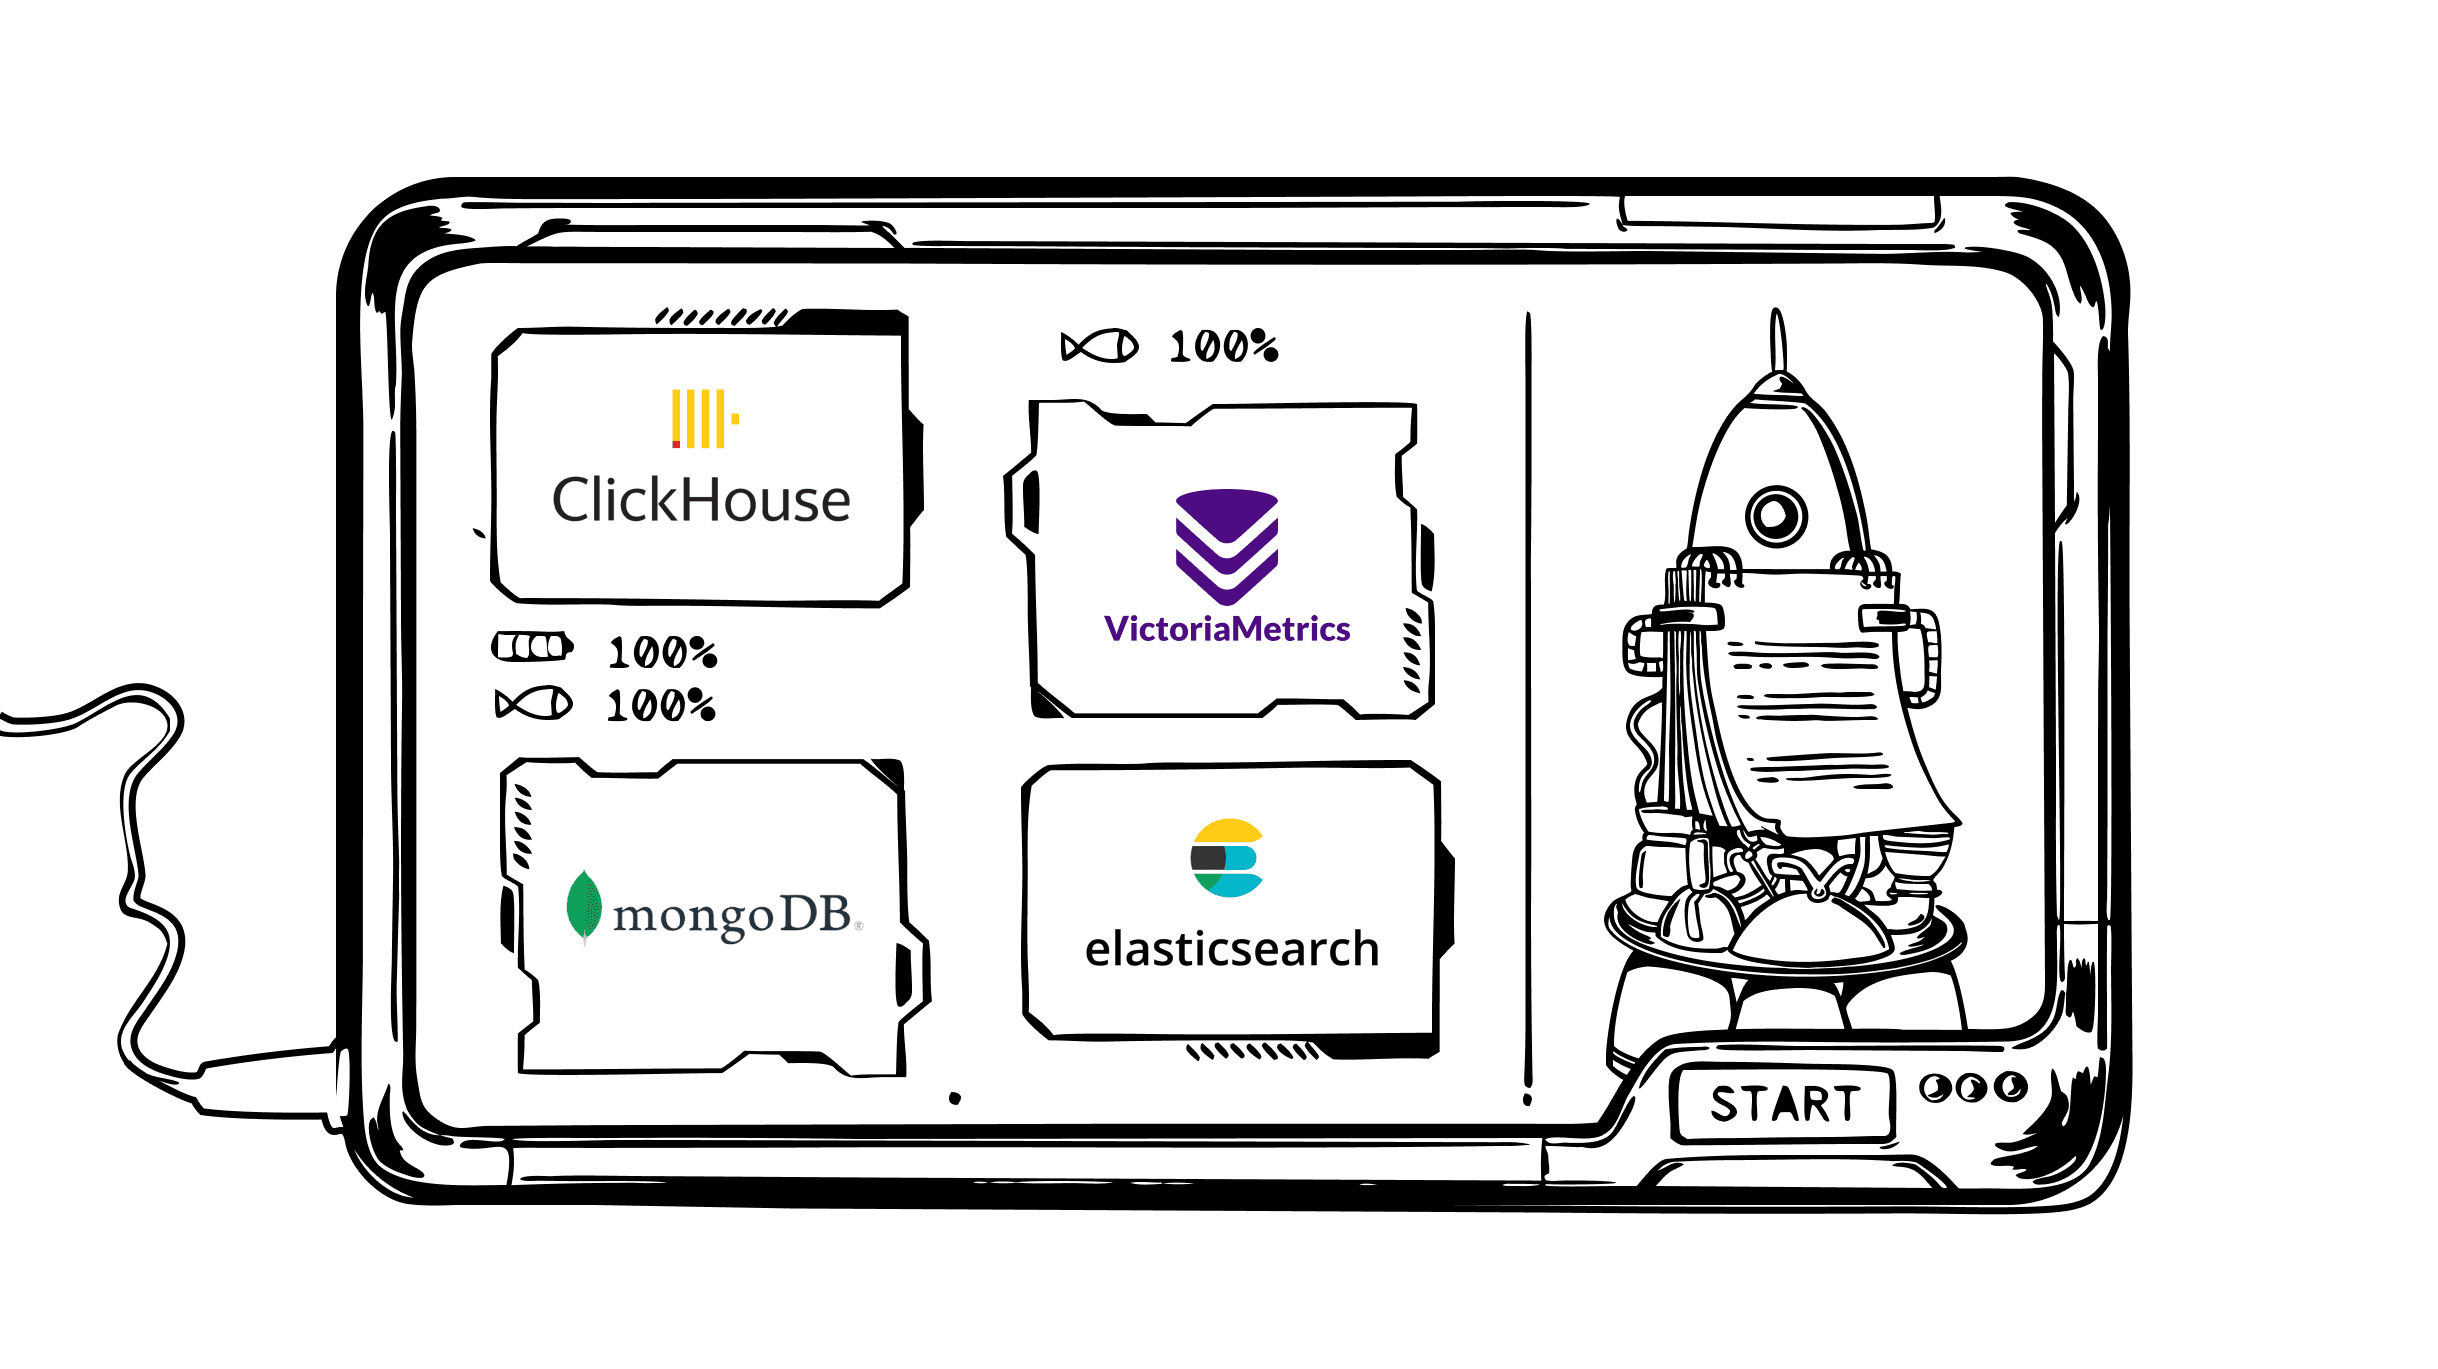
Для клиентской аналитики использовали ClickHouse. В него складывали данные о решениях антифрод-системы, чтобы заказчики ТехноСкора могли смотреть статистику по транзакциям. За метрики отвечала VictoriaMetrics, за логи — Elasticsearch.
У этой схемы было несколько ограничений.
Провайдер старой площадки не всегда подробно разбирал инфраструктурные инциденты. Когда у сервиса случались задержки или пропадал трафик, команда не всегда получала понятный ответ, что произошло и может ли это повториться. Для антифрод-платформы такая неопределённость опасна: ТехноСкору нужно управлять SLA перед своими клиентами и заранее понимать, где в инфраструктуре могут быть слабые места.
Модель оплаты тоже была неудобной: ресурсы оплачивались как фиксированный пул квот (а это значит, что компания платит за выделенные мощности, даже если часть из них сейчас не используется). В облаке команда хотела перейти к оплате фактического потребления.
Ещё одно ограничение касалось отказоустойчивости. В старой схеме было меньше возможностей для зонального резервирования. Если площадка ведёт себя непредсказуемо, это становится проблемой: команду интересует не обещание вечного аптайма, а понятная картина рисков и возможность разнести критичные сервисы по разным зонам.
Параллельно ТехноСкор развивал новую версию продукта. Старые сервисы были написаны на Scala, новую версию команда делала на Rust. Rust лучше подходил для нового контура, где нужно быстро обрабатывать запросы и аккуратно работать с ресурсами.
Команда не стала копировать старую систему в облако как есть. Новую площадку сразу собирали под Rust-версию продукта.
KTS отвечали за инфраструктурную часть. Нужно было:
Продуктовую часть развивал ТехноСкор. Его команда писала новую версию платформы, сравнивала поведение старой и новой логики, договаривалась со своими клиентами о техокнах для перехода. KTS готовили инфраструктуру и делали так, чтобы этот переход можно было провести аккуратно.
Yandex Cloud закрывал несколько проблем старой площадки.
Инциденты могут случиться у любого провайдера. Для ТехноСкора было важно другое: быстро узнать о проблеме, получить постанализ и понять, как учитывать такие риски в архитектуре. В Yandex Cloud картина стала понятнее. Команда видит больше данных по инфраструктуре и может спокойнее планировать меры на своей стороне.
Вместо заранее выкупленного пула команда перешла к оплате фактического потребления. Для инфраструктуры, где нагрузка и состав сервисов меняются, это удобнее.
В Yandex Cloud команда использовала зоны доступности, Security Groups и управляемые сервисы там, где это было уместно. Security Groups — это правила сетевого доступа на уровне облака. Они помогают описать, кто к кому может ходить по сети, и не держать весь контур безопасности только на самописной обвязке.
Поверх облачных правил KTS добавили свои слои защиты, например, OpenVPN для безопасного доступа инженеров. Так базовая сетевая логика переехала на сторону облака, а прикладные ограничения остались под контролем команды.
Новая архитектура разделила критичный production-контур и вспомогательные сервисы.
Ключевые сервисы на Rust работают на виртуальных машинах. Такой вариант выбрали осознанно. Rust-версия продукта на этом этапе была обвязкой вокруг in-memory базы данных, и для такого сервиса важно выжимать максимум из машины и не добавлять лишние точки отказа там, где в них нет необходимости.
Kubernetes остался, но его роль изменилась. Теперь он отвечает за вспомогательный слой. Там работают:
Старая Scala-версия осталась в Kubernetes как внутренний стенд и получила прозвище «монумент». Она больше не обрабатывает клиентский production-трафик, зато помогает сравнивать старую и новую логику на отдельных сценариях.
Антифрод-платформа должна отвечать быстро, поэтому команда смотрит не только на среднее время ответа. В проекте важен 99-й перцентиль (то есть нужно понимать, сколько времени занимает 1% самых медленных запросов). Даже если в среднем всё хорошо, но отдельные запросы проходят дольше ожидаемого, клиент всё равно может заметить деградацию.
Этот слой нужен не только DevOps-инженерам. Когда случается деградация, ТехноСкор должен понять это раньше клиента, предупредить заинтересованные команды и разобраться, какой компонент повлиял на задержку.
Самая чувствительная часть проекта была связана с клиентским трафиком.
Сначала весь production-трафик продолжал идти в старый контур. Старая версия продукта обрабатывала запросы и возвращала ответы клиентам. Для банков, страховых и других клиентов ТехноСкора ничего не менялось.
Параллельно KTS настроили зеркалирование. Тот же поток запросов параллельно направлялся в Yandex Cloud, где его получала новая Rust-версия. Она обрабатывала копии реальных запросов, но её ответы пока не уходили клиентам.
Так команда ТехноСкора могла сравнивать две версии на настоящей нагрузке. Смотрели, как совпадают решения, как новая версия ведёт себя в спорных случаях и сколько времени занимает обработка. Это безопаснее синтетических тестов, потому что продукт видит реальные сценарии, но клиенты всё ещё получают ответы от прежней версии.
Когда новая версия была готова, начался поэтапный переход. ТехноСкор договаривался с каждым клиентом о времени переключения и передавал новый эндпоинт. В удобное техокно клиент менял адрес у себя в конфигурации и начинал отправлять запросы в новую инфраструктуру.
Некоторое время старые и новые адреса работали параллельно. Поэтому у клиентов не было жёсткого дедлайна, когда нужно переключиться всем сразу.