отслеживайте,
где инфраструктура создаёт риски
для бизнеса

Диагностика инфраструктуры для руководителей цифровых продуктов

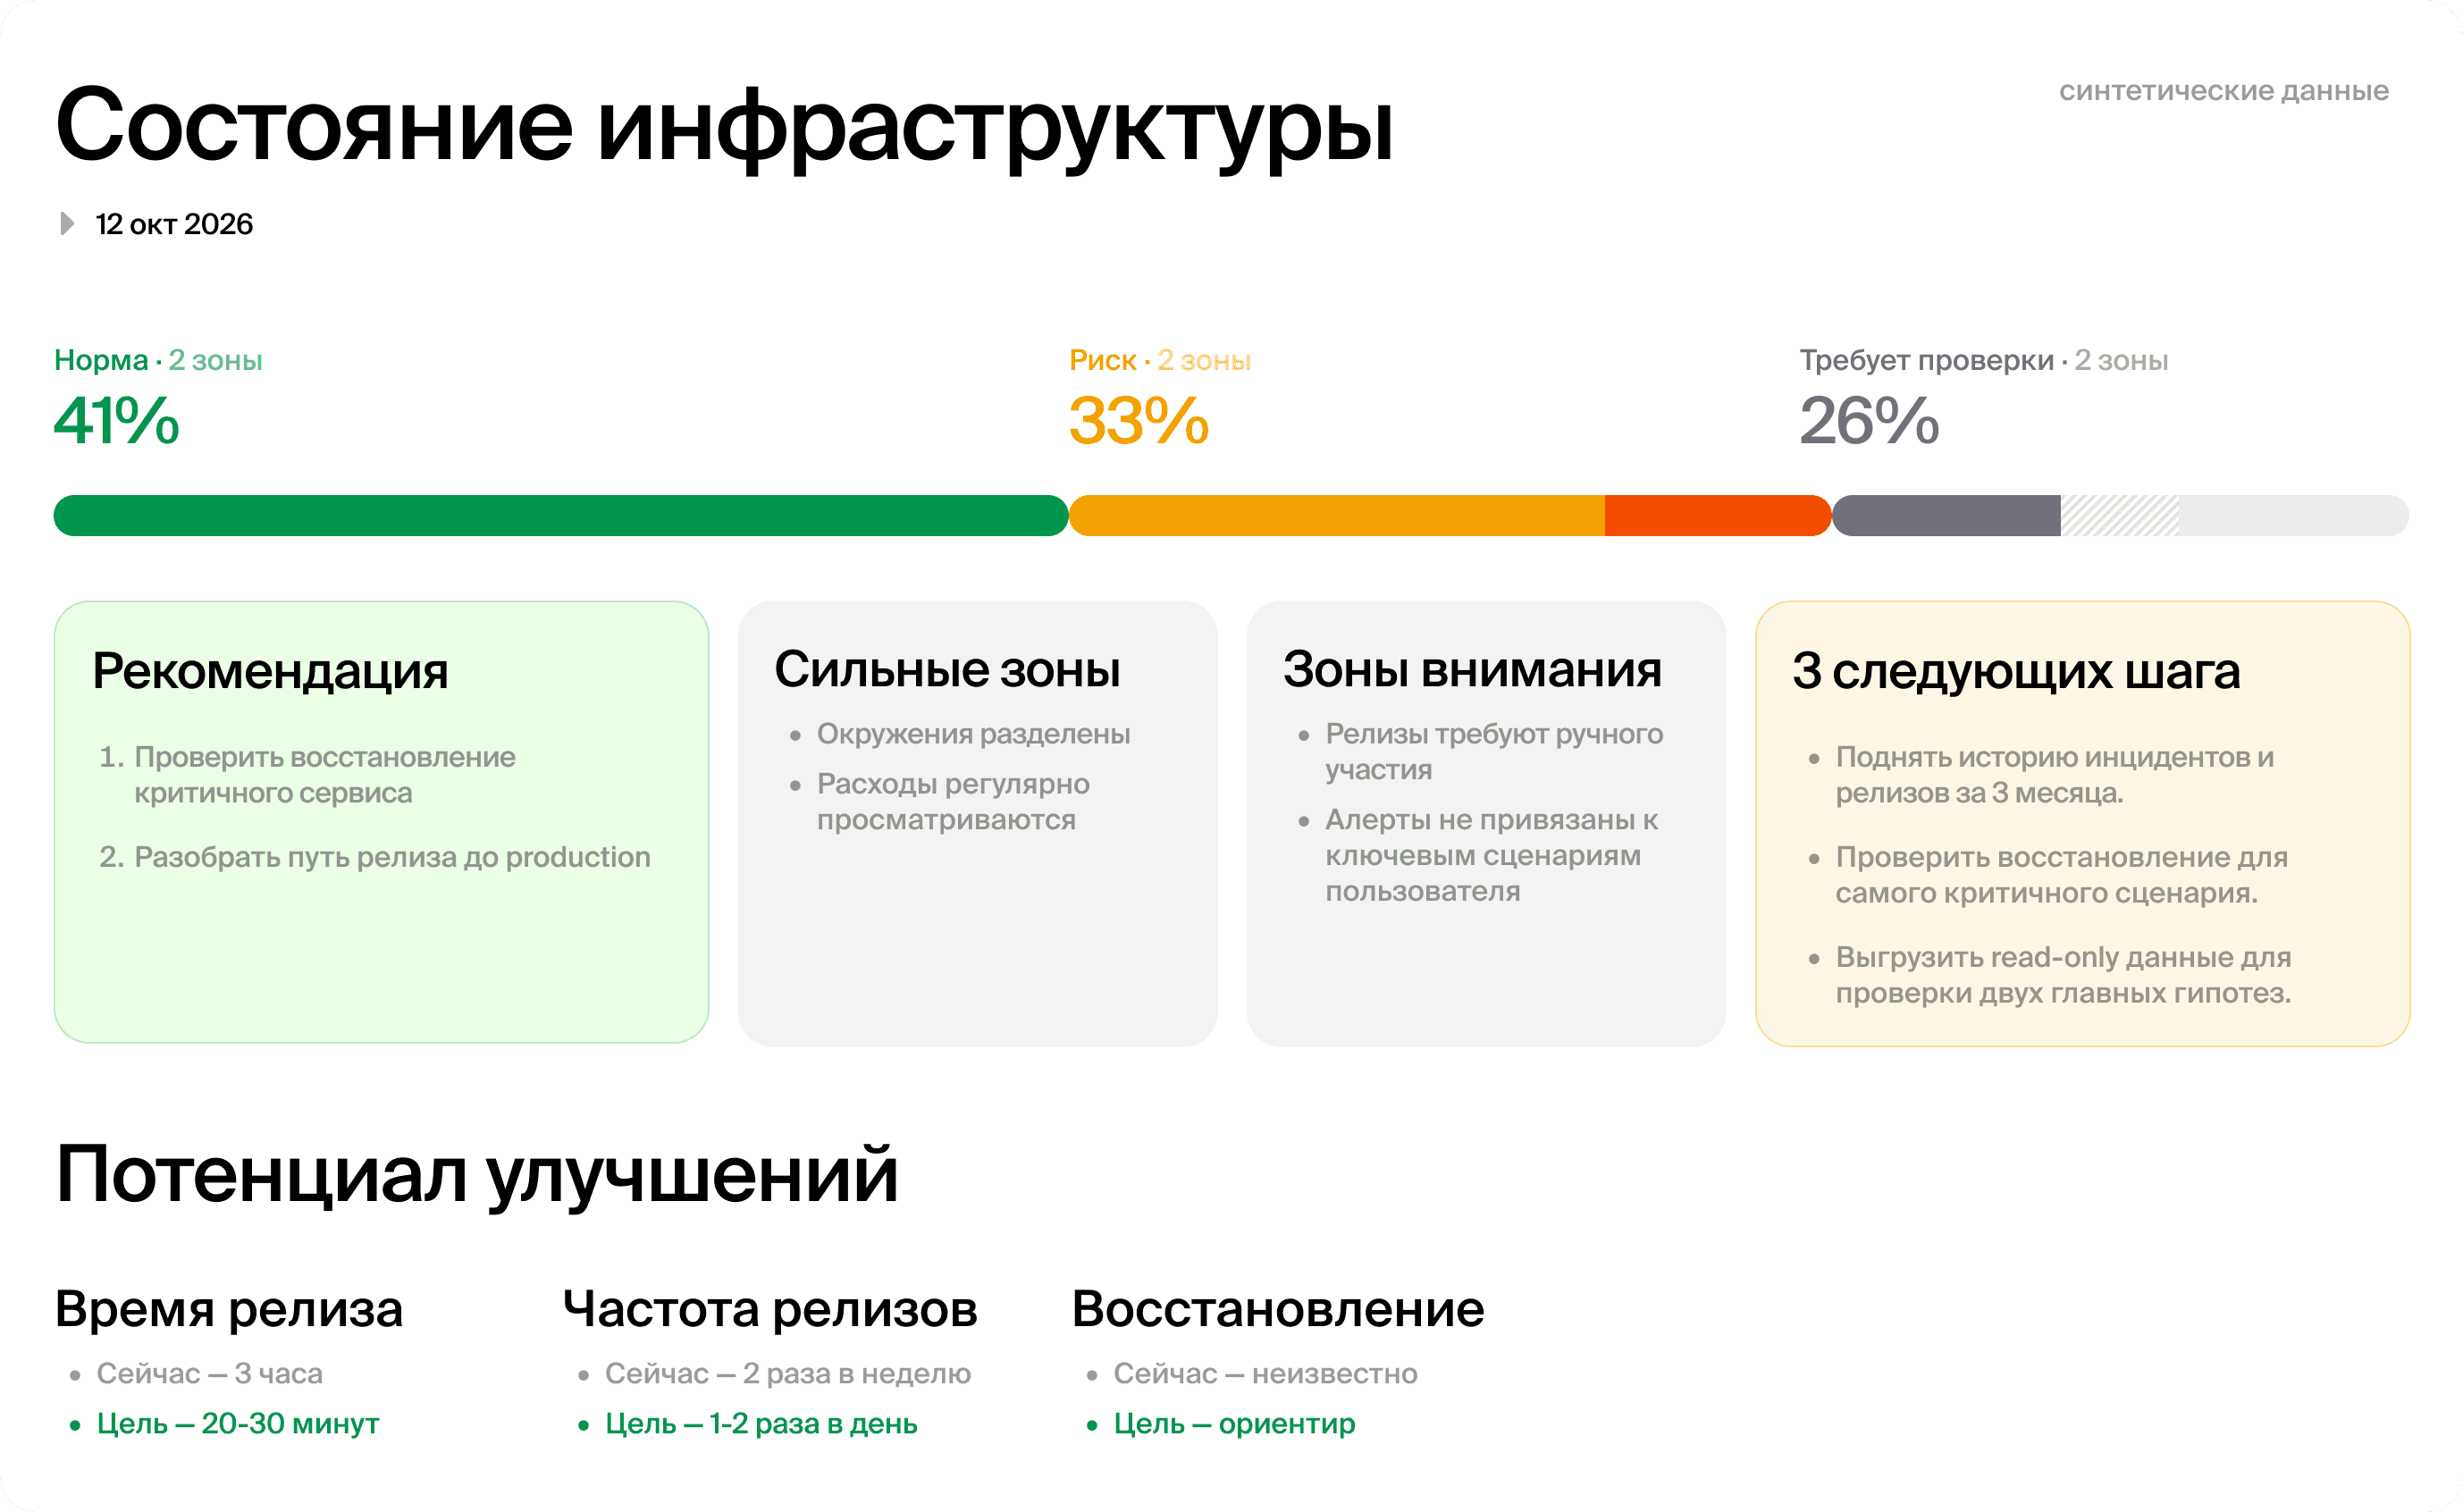
Состояние инфраструктуры

Когда нужна диагностика?

Сбои повторяются

Каждый инцидент выглядит новым, но количество инцидентов не снижается.
Повторяющиеся сбои

Релизы стали рискованными

Каждая выкладка требует повышенного внимания, а откат не гарантирует быстрое восстановление
Рискованные релизы

Бизнес не понимает, за что платит

Расходы на инфраструктуру растут быстрее продукта, а объяснить структуру затрат сложно
Рост расходов на инфраструктуру

О проблеме узнают от клиентов

Мониторинг формально есть, но не даёт бизнесу и команде своевременного сигнала
Оповещения от клиентов

Всё держится на нескольких людях

Без отдельных инженеров релиз, восстановление или диагностика резко усложняются.
Ключевые сотрудники

Нужно принять крупное решение

Впереди масштабирование, миграция, импортозамещение или серьёзный инфраструктурный бюджет
Крупное инфраструктурное решение

Часть рисков
вы уже знаете

Задача диагностики показать, где система держится на допущениях и непроверенных предположениях
Известные риски

Получите ответы на главные управленческие вопросы

Соответствуют ли расходы реальной нагрузке?

Насколько быстро и предсказуемо команда выпускает изменения?

Где находятся наиболее вероятные точки отказа и как они могут повлиять на продукт?

Видите ли вы угрозы до того, как они влияют на клиентов?

Где инфраструктура может отказать и как это ударит по продукту?

Можно ли восстановить критичные сервисы в приемлемый срок?

Соответствуют ли расходы реальной нагрузке?

Насколько быстро и предсказуемо команда выпускает изменения?

Где находятся наиболее вероятные точки отказа и как они могут повлиять на продукт?

Видите ли вы угрозы до того, как они влияют на клиентов?

Где инфраструктура может отказать и как это ударит по продукту?

Можно ли восстановить критичные сервисы в приемлемый срок?

покажем текущий уровень, достижимый потенциал и цену изменений

Состояние инфраструктуры
Декоративный зелёный эллипс

Исследуем систему по 6 направлениям

Архитектура и отказо­устойчивость

Где находятся наиболее вероятные точки отказа и как они повлияют на продукт?
Подробнее
Где находятся наиболее вероятные точки отказа и как они повлияют на продукт?

Архитектура и отказо­устойчивость

  • Связи сервисов, баз, очередей и внешних зависимостей
  • Одиночные точки отказа в критичных сценариях
  • Резервирование и изоляция окружений
  • Совпадает ли схема в документации с тем, что развёрнуто
HAreplicationtopologyIaC
  • Связи сервисов, баз, очередей и внешних зависимостей
  • Одиночные точки отказа в критичных сценариях
  • Резервирование и изоляция окружений
  • Совпадает ли схема в документации с тем, что развёрнуто
HAreplicationtopologyIaC

Релизы и изменения

Насколько быстро, просто и предсказуемо команда может выпускать изменения?
Подробнее
Насколько быстро, просто и предсказуемо команда может выпускать изменения?

Релизы и изменения

  • Путь от коммита до production
  • Какие шаги релиза выполняются вручную
  • Как выполняется откат и проверялся ли он
  • Связь релизов с инцидентами и мониторингом
CI/CDrollbackGitOpschange control
  • Путь от коммита до production
  • Какие шаги релиза выполняются вручную
  • Как выполняется откат и проверялся ли он
  • Связь релизов с инцидентами и мониторингом
CI/CDrollbackGitOpschange control

Доступы, секреты и данные

Контролируете ли вы, кто может изменить production, и восстановятся ли данные?
Подробнее
Контролируете ли вы, кто может изменить production, и восстановятся ли данные?

Доступы, секреты и данные

  • Кто имеет доступ к production и по какому принципу
  • Где хранятся и как обновляются секреты
  • Резервные копии критичных данных
  • Проверялось ли восстановление на практике
IAMsecretsbackup/restoreaudit log
  • Кто имеет доступ к production и по какому принципу
  • Где хранятся и как обновляются секреты
  • Резервные копии критичных данных
  • Проверялось ли восстановление на практике
IAMsecretsbackup/restoreaudit log

Мониторинг и реагирование

Можно ли своевременно увидеть реальную угрозу и предотвратить её до влияния на пользователей?
Подробнее
Можно ли своевременно увидеть реальную угрозу и предотвратить её до влияния на пользователей?

Мониторинг и реагирование

  • Покрыты ли мониторингом критичные пользовательские сценарии
  • Есть ли метрики, понятные бизнесу: доступность, ошибки, задержки
  • Как приходит сигнал об инциденте и кто реагирует
  • Что происходит после инцидента
observabilitySLO/SLIalertingMTTR
  • Покрыты ли мониторингом критичные пользовательские сценарии
  • Есть ли метрики, понятные бизнесу: доступность, ошибки, задержки
  • Как приходит сигнал об инциденте и кто реагирует
  • Что происходит после инцидента
observabilitySLO/SLIalertingMTTR

Стабильность и восстановление

Что произойдёт при скачке нагрузки, отказе узла или серьёзном инциденте?
Подробнее
Что произойдёт при скачке нагрузки, отказе узла или серьёзном инциденте?

Стабильность и восстановление

  • Какое время восстановления и потери данных приемлемы для бизнеса
  • Когда последний раз проверяли восстановление
  • Есть ли инструкции на типовые отказы
  • Что будет при росте нагрузки в 2–3 раза
DRRTO/RPOfailoverload testing
  • Какое время восстановления и потери данных приемлемы для бизнеса
  • Когда последний раз проверяли восстановление
  • Есть ли инструкции на типовые отказы
  • Что будет при росте нагрузки в 2–3 раза
DRRTO/RPOfailoverload testing

Ресурсы и стоимость

Платите ли вы за мощности, которые реально используются продуктом?
Подробнее
Платите ли вы за мощности, которые реально используются продуктом?

Ресурсы и стоимость

  • Из чего состоит счёт провайдера
  • Выделенные мощности против фактической утилизации
  • Ресурсы, владельца которых никто не знает
  • Контроль бюджета и алерты на расходы
utilizationright-sizingFinOps
  • Из чего состоит счёт провайдера
  • Выделенные мощности против фактической утилизации
  • Ресурсы, владельца которых никто не знает
  • Контроль бюджета и алерты на расходы
utilizationright-sizingFinOps
Оставить заявку

Что входит
в диагностику

  • Архитектура

    Отказоустойчивость, окружения и запуск сервисов

  • Инфраструктурные процессы

    Ручные действия и зависимость от отдельных людей

  • Мониторинг

    Инциденты, реагирование и восстановление сервисов

  • Расходы и утилизация

    Нагрузка, мощности и первичные FinOps-сигналы

  • Доставка изменений

    CI/CD, откаты, конфигурации, артефакты и секреты

и что не входит в работу

  • Трансформация SDLC

    Не проводим аудит всей SDLC-организации

  • Оценка инженеров и команд

    Не оцениваем уровень конкретных специалистов и зрелость команд

  • Аттестация и сертификация

    Не подтверждаем соответствие 152-ФЗ и другим требованиям

  • Pentest и compliance-аудит

    Не заменяем полноценный pentest, compliance и формальные проверки

  • Гарантия отсутствия инцидентов

    Не обещаем, что инцидентов больше не будет

карта рисков после диагностики

Если по её итогам не видно причины начинать аудит — мы так и скажем

Карта рисков инфраструктуры

Проверим системупо фактическим данным

Обязательные разделы отчёта

На выходе вы получаете готовый документ, с которым можно идти к команде или к подрядчикам
Кот с ноутбуком

Инженеры, которые сами отвечают за production

Инженеры, которые сами отвечают за production

Без lock-in

Отчёт написан так, чтобы его могла выполнить ваша команда или любой другой подрядчик
Без lock-in

Без фанатизма

Если достаточно точечных изменений, мы не будем рекомендовать перестройку платформы.
Без фанатизма

Кто исполнитель?

Диагностику проводит Senior DevOps-инженер или руководитель направления
Senior DevOps-инженер

Мы пишем статьи
и активно делимся знаниями

Выберите диагностику

Первичная

Первый шаг, без обязательств. Заключение на следующий рабочий день

  • Задача

    Понять, где проблема и нужен ли аудит вообще.

  • Что исследуем

    Все 6 направлений на уровне структурированного интервью.

  • Что получаете

    Заключение: статусы по 6 направлениям, сильные зоны, зоны риска, критичные неизвестные, 3 гипотезы, 3 следующих шага и рекомендацию формата.

  • Доказательность

    Предварительная оценка по интервью.

  • Доступы

    Не нужны, агенты не устанавливаются.

  • Участие клиента

    1 онлайн-встреча 60 минут. Полезно, если участвует технический специалист.

бесплатно1 час

Экспресс

Всё из первичной + проверка по данным

  • Задача

    Быстро проверить ключевые гипотезы по фактическим данным.

  • Что исследуем

    Облако, мониторинг, CI/CD, конфигурации и утилизацию ресурсов по read-only данным.

  • Что получаете

    Доказанные ключевые риски с фактами и доказательствами, приоритеты, рекомендации, презентацию и разбор результатов на встрече.

  • Доказательность

    Факты по ключевым областям, ограниченная глубина.

  • Доступы

    Read-only, без изменений в инфраструктуре.

  • Участие клиента

    2–3 онлайн-встречи по 40–60 минут.

180000 ₽5 рабочих дней

Комплексная

Всё из экспресс + полный отчёт и план

  • Задача

    Принять инвестиционное решение и получить план изменений.

  • Что исследуем

    Все направления, системные зависимости, инфраструктурные процессы, фактические данные и уточняющие интервью.

  • Что получаете

    Отчёт с резюме для руководства, реестром рисков, фактическим состоянием, планом изменений и разделом «что делать не нужно», целевую схему и презентацию результатов.

  • Доказательность

    Полная картина по фактическим данным.

  • Доступы

    Read-only, без изменений в инфраструктуре.

  • Участие клиента

    3–7 онлайн-встреч по 40–60 минут.
от 450000 ₽3-4 недели

Как проходит диагностика

1
Контекст
Критичные пользовательские сценарии, планы бизнеса, история инцидентов и ограничения
2
Данные
Read-only доступ к облаку, инфраструктуре как коду, мониторингу, CI/CD, документации и конфигурациям.
3
Интервью
Онлайн-встречи по 40–60 минут только с теми, у кого нужно уточнить факты и процессы.
4
Анализ
Для каждого значимого вывода: доказательство, риск, влияние на бизнес и приоритет.
5
Отчёт
Фактическое состояние, ключевые зависимости, реестр рисков и план изменений в одном связанном документе.
6
Презентация и разбор
Встреча 1–2 часа: ключевые риски, компромиссы, первый шаг и то, что делать не нужно.

Вопросы

Вы будете что-то устанавливать в нашей инфраструктуре?
Нет. На первичной диагностике работаем только через интервью: ни агентов, ни дополнительного софта. В экспресс- и комплексной диагностике используем read-only доступ: ничего не меняем, не перезапускаем и не устанавливаем.
Мы не даём доступ в production
Полный доступ не нужен. Для экспресс- и комплексной диагностики достаточно прав на чтение: облако, репозитории с инфраструктурой как кодом, мониторинг и CI/CD. Если read-only невозможен, обозначим ограничения точности выводов до старта работ.
Сколько времени потребуется от нашей команды?
Первичная диагностика — одна онлайн-встреча на 60 минут. Экспресс-диагностика — 2–3 онлайн-встречи по 40–60 минут. Комплексная диагностика — 3–7 онлайн-встреч по 40–60 минут за 3–4 недели. Основную картину собираем по данным, а не неделями интервью.
Вы будете оценивать наших инженеров?
Нет. Мы оцениваем инфраструктуру и связанные с ней процессы, а не людей. Оценку зрелости команд и профессионального уровня специалистов мы не проводим и не обещаем.
У нас сильные инженеры. Зачем внешний взгляд?
Диагностика превращает известные и неизвестные проблемы в сравнимые риски с доказательствами и приоритетом. Это помогает руководителю принять решение о бюджете, а команде — получить аргументы для того, что она и так предлагала.
Вы специально найдёте больше проблем, чтобы продать внедрение?
Отчёт независим: его может выполнить ваша команда или другой подрядчик. В отчёте есть отдельный раздел «что делать не нужно», и мы не предлагаем технологию до диагностики проблемы.
Мы и так знаем свои проблемы
Часть рисков вы знаете. Ценность — в приоритете и в том, что видно со стороны: что реализуется первым, во что это обойдётся, какие есть зависимости и где риск держится на непроверенном допущении.
Можно ли сделать это с помощью AI?
Список вопросов собрать можно. Дальше нужно извлечь фактические данные системы, сопоставить находки между областями, ранжировать риски и отвечать за выводы. Именно здесь нужен инженерный опыт эксплуатации production.
А если аудит не нужен?
Так и скажем после первичной диагностики и объясним, при каких условиях стоит вернуться. Отказ от лишней работы стоит нам одного часа, а вам экономит бюджет.
01
Созвонимся, чтобы понять вашу текущую ситуацию
02
Сформируем предложение, исходя из максимизации пользы при минимуме затрат
03
Внедрим и по необходимости кастомизируем сервис под ваши бизнес-процессы
04
Возьмём на поддержку, если нужно

Расскажите
о задаче
Мыпредложим
решение
Расскажите
о задаче
Мы предложим
решение